原文作者:意琦行 本文转载自:HAMi 正式接入 Kubernetes DRA:下一代 GPU 资源模型实践指南
HAMi 是目前 Kubernetes 上最活跃的开源 vGPU 方案,能够将一块物理 GPU 按显存和算力细粒度地切分为多个虚拟 GPU,供不同 Pod 共享。
本文聚焦 HAMi DRA 模式的部署与使用:安装 HAMi DRA 驱动后,分别用原生模式和兼容模式提交 Pod,验证 GPU 切分是否生效。
Kubernetes 在 1.34 中正式 GA 了 DRA(Dynamic Resource Allocation,动态资源分配)。DRA 的核心改进是让调度器参与资源分配,在 Pod 调度阶段就精确匹配设备属性,避免了 DevicePlugin “调度到节点后才发现资源不够” 的问题。
HAMi 最近的版本已经正式接入了 DRA,用户既可以使用原生 DRA 模式,也可以用 DevicePlugin 兼容模式无缝迁移。
HAMi(异构 AI 计算虚拟化中间件)是一个用于管理 Kubernetes 集群中异构 AI 计算设备的开源平台。前身为 k8s-vGPU-scheduler,HAMi 可在多个容器和工作负载之间实现设备共享。
HAMi 是云原生计算基金会(CNCF)的 Sandbox 项目,并被收录于 CNCF 技术全景图和 CNAI 技术全景图。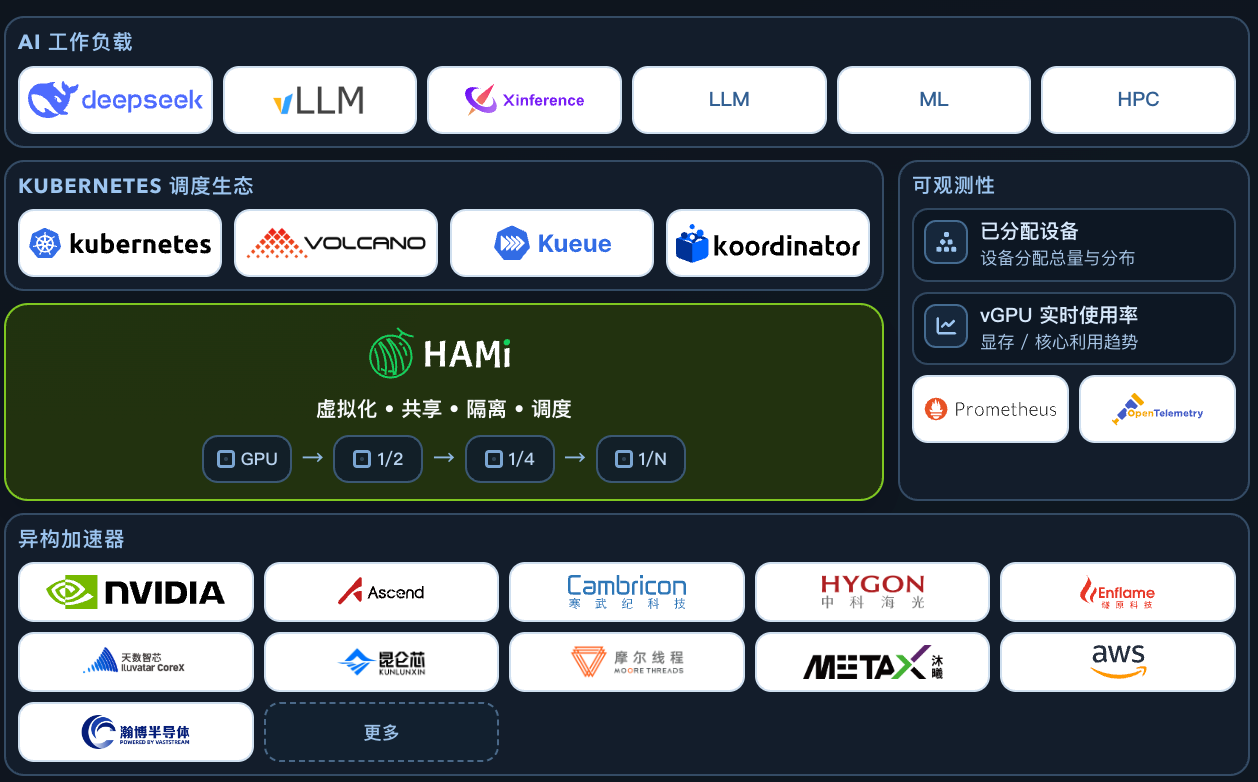
设备共享多设备支持:兼容多种异构 AI 计算设备(GPU、NPU 等)共享访问:多个容器可同时共享设备,提高资源利用率
内存管理硬限制:在容器内强制执行严格的内存限制,防止资源冲突动态分配:根据工作负载需求按需分配设备内存灵活单位:支持按 MB 或占总设备内存百分比的方式指定内存分配
设备规格类型选择:可请求特定类型的异构 AI 计算设备UUID 定向:使用设备 UUID 精确指定特定设备
易用性对工作负载透明:容器内无需修改代码简单部署:使用 Helm 轻松安装和卸载,配置简单
开放治理社区驱动:由互联网、金融、制造业、云服务等多个领域的组织联合发起中立发展:作为开源项目由 CNCF 管理
前提条件:K8s 1.34 及以上版本,同时开启 DRAConsumableCapacity Feature Gate 1.34-1.35 DRAConsumableCapacity 默认未开启,需要手动配置
Container Runtime 必须开启 CDINVIDIA GPU 驱动 440 及以上版本
特别是第一条,DRAConsumableCapacity 在 1.36 才默认开启,1.34、1.35 需手动配置。
安装 GPU Operator 时需要关闭 DevicePlugin:
:关闭 DevicePlugin,避免与后续安装的 DRA Driver 冲突。
HAMi DRA Webhook 需要 TLS 证书,因此需要提前安装 cert-manager 用于自动签发。
为节点打上 标签,未标记的节点不会被 HAMi 接管。
使用以下命令添加 HAMi 图表仓库:
用以下命令进行安装:
注意:DRA 模式与传统模式不兼容,请勿同时启用。
另外如果 GPU 驱动是主机预装,非 GPU Operator 安装,则安装时需额外指定:
正常情况下,会在 hami-system 下启动以下 Pod
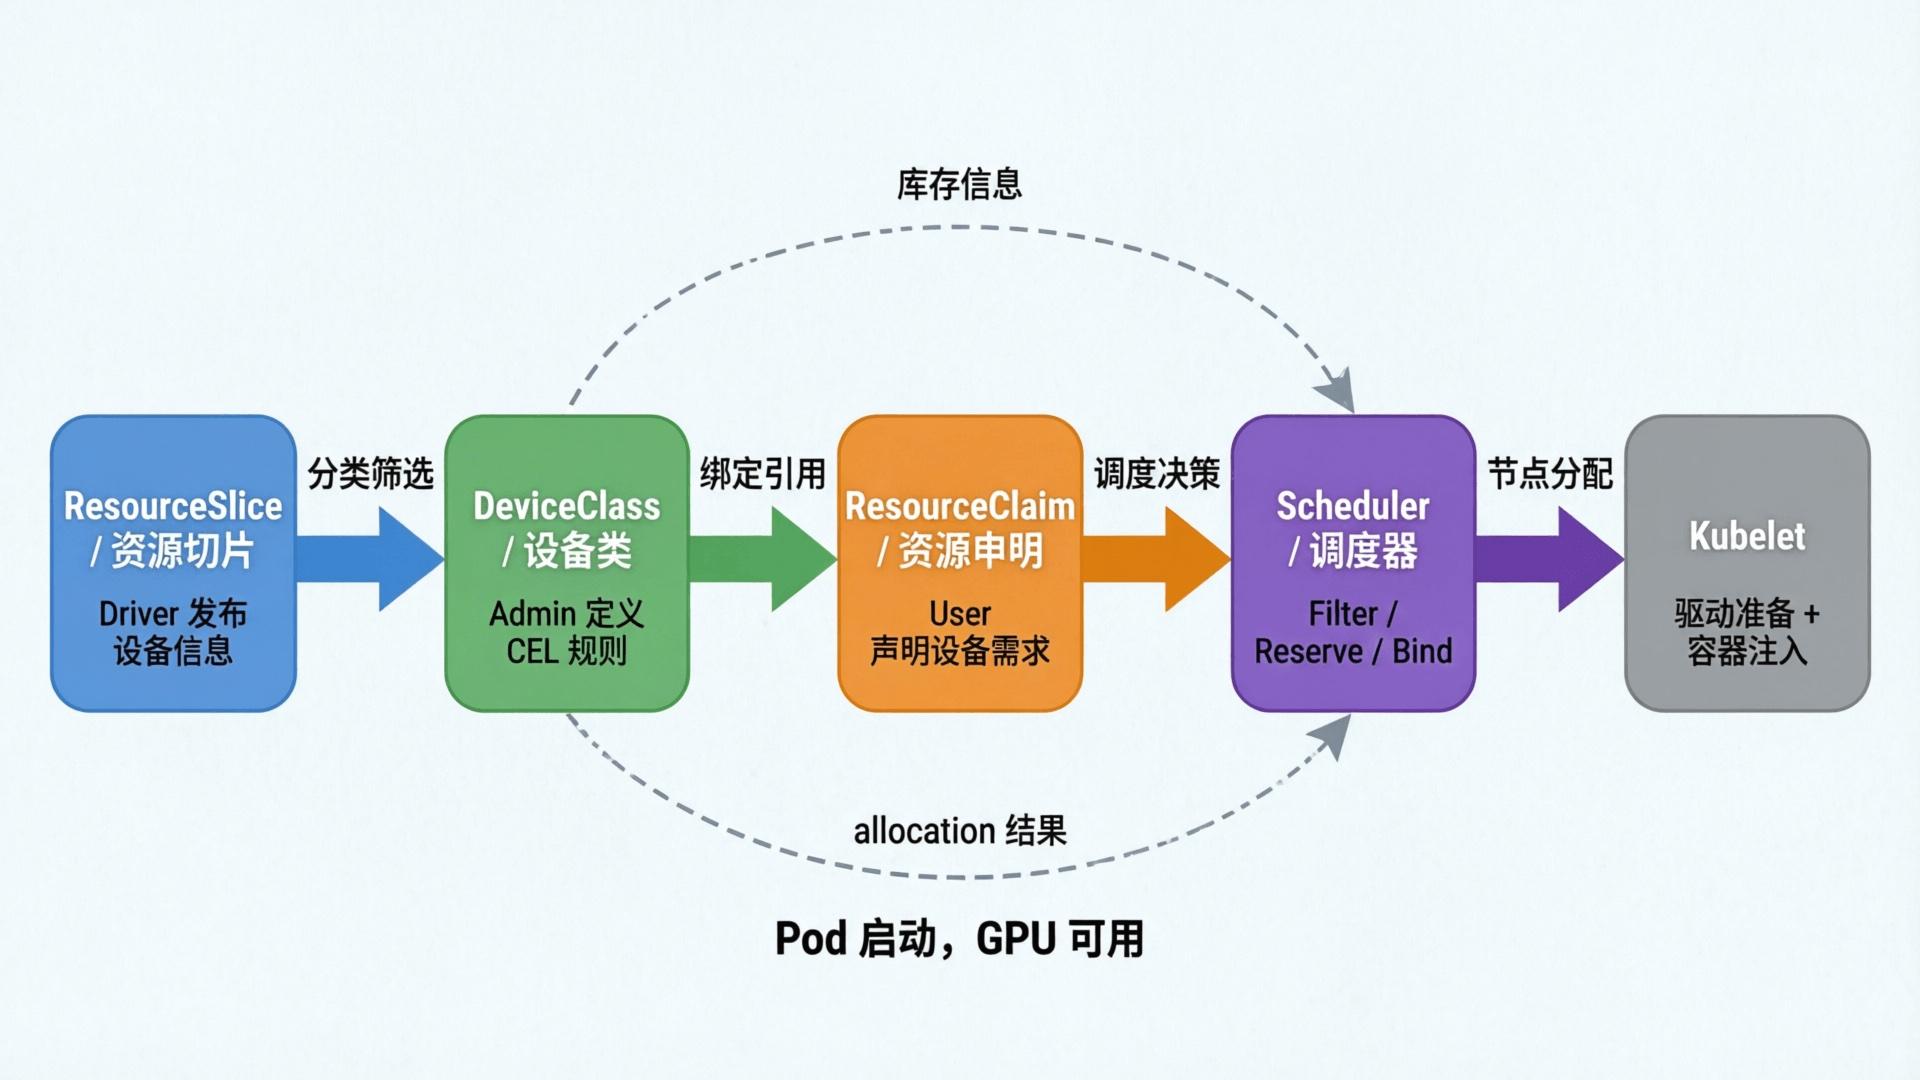
查看 dra-driver 是否正常发布 resourceslice:
详情如下:
可以看到,ResourceSlice 记录了 GPU 的架构、型号、显存等信息。
DRA 原生使用流程是先创建 ResourceClaim,然后创建 Pod 使用该 ResourceClaim。
ResourceClaim 以及对应 Pod 完整 yaml 如下:
通过 ResourceClaim 可以看到资源分配情况:
Pod 中执行 nvidia-smi 看到显存是我们申请的 10G,说明 HAMi 生效了。
原生 DRA 模式需要手动创建 ResourceClaim,对存量业务不够友好。
为了便于大家迁移,HAMi 提供了兼容模式:用户仍然像 DevicePlugin 那样申请资源,由 HAMi DRA Webhook 自动拦截并转换为 ResourceClaim,调度器分配后再挂载到 Pod。
和使用 DevicePlugin 一样,正常在 resources 中申请资源即可:
HAMi 会根据 、 自动生成 ResourceClaim,并绑定到 Pod。
对应的 ResourceClaim 如下:
核心配置:
对比原始 Pod 的资源申请:
Webhook 转换映射关系:原始资源申请ResourceClaim 字段http://nvidia.com/gpu: 1requests.count: 1http://nvidia.com/gpumem: 10240requests.capacity.memoryhttp://nvidia.com/gpucores: 50requests.capacity.cores
同样的,显存为 10240M,说明 HAMi 也生效了。
本文围绕 HAMi DRA 模式完成了从安装到验证的完整实践:部署 HAMi DRA:关闭 DevicePlugin 后通过 Helm 安装 HAMi,开启 DRA 原生模式:手动创建 ResourceClaim 声明显存与算力,Pod 通过 resourceClaim 引用DevicePlugin 兼容模式:沿用传统 等资源申请,HAMi DRA Webhook 自动转换为 ResourceClaim,存量业务零改造即可迁移
两种模式的核心差异在于 ResourceClaim 的创建方式——原生模式手动管理、兼容模式自动生成,底层调度与切分逻辑一致。
HAMi 是 CNCF 托管的开源项目与社区,核心方向是 GPU 虚拟化与异构算力调度,面向 AI 场景提升算力利用效率;其目标是实现 灵活、按需、弹性、可靠 的 GPU 虚拟化,并持续扩展对主流 AI 芯片生态的支持。
「密瓜智能(Dynamia) 」专注 GPU 虚拟化与异构算力调度,发起并主导 CNCF 开源项目 HAMi;同时基于 HAMi 提供商业发行版、企业产品与服务,帮助用户在真实业务中规模化使用相关能力
官网:dynamia.ai
邮箱:info@dynamia.ai
HAMi 项目地址:https://github.com/project-hami/hami
原文地址:https://www.lixueduan.com/posts/kubernetes/56-hami-dra-quickstart/
本文作者「Dynamia密瓜智能」